腾讯云原生湖仓产品DLC内核研发负责人。毕业于复旦大学数学系,丰富的公有云大数据经验,打造业界领先的云原生湖仓数据平台,在数据湖存储,severless计算,统一元数据有丰富落地经验。
2015年就职于小米手环 从0基于aws s3构建存算分离架构下的大数据平台,并且适应全球合规架构;
2018年加入出海头部企业Shareit,aws/华为云/阿里云多云环境下构建全球合规10PB级云原生数据湖架构:spark native on k8s业界最早应用于10PB级生产环境,数据湖table format应用解决s3对象存储性能和成本优化(iceberg、hudi),大数据severless服务平台及工具链平台(genie、airflow、superset)。
2020年加入腾讯TEG数据平台部,全面负责腾讯云原生湖仓产品DLC的架构研发。
讲师介绍
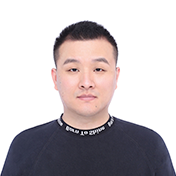
专题演讲嘉宾:于华丽
腾讯云腾讯大数据专家工程师
议题介绍
时间:04月15日 16:15
所属专题:腾讯云基础软件创新实践专场
演讲: 一份数据满足所有数据场景? 腾讯云数据湖解决方案及DLC核心技术介绍
演讲摘要:
数据湖是一种越来越受欢迎的数据存储和分析方法,可解决处理海量异构数据的难题。
云上数据湖解决方案的核心架构原则SSOT,即一份数据满足不同形态、不同引擎、不同大数据云产品的绝大部分大数据需求,无需数据移动、冗余,极大程度的降低用户云上存储成本。
云原生背景下,大数据与云原生技术更加紧密的结合,基于容器k8s的大数据弹性计算架构也越来越普及,能够为用户极大程度降低云上计算成本。
今天的分享整体介绍腾讯云数据湖解决方案及数据湖计算产品DLC的架构原则和技术选型。
演讲大纲:
一、腾讯云数据湖解决方案架构
1、架构原则SSOT,云上数据产品深度连接,一份数据满足绝大多数需求
2、DLC:全托管云原生数据湖产品形态
二、腾讯云数据湖DLC内核技术揭秘,架构原则 KISS,适应云原生
1、成本相关:数据湖表格式、DLC特有虚拟集群弹性模型
2、分析性能相关:常驻共享sparkcontext、统一sql/view/udf presto无感分析加速、local cache加速分析、海量元数据、数据湖格式加速分析
3、ETL稳定心相关:DLC spark shuffle manager设计、解决对象存储一致性、无rename问题
三、新一代数仓建设
1、如何利用文件格式建立高效低成本的稀疏索引
2、增量数仓新范式
3、展望实时增量数仓
听众收益:
1、如何玩转云上大数据,构建低成本、高性能、稳定的数据业务平台
2、数据平台优化思路
3、大数据计算引擎的最新动态
关注主办方(InfoQ)
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质
电话咨询
联系电话:+86 13240419330
在报名过程中如有任何问题,欢迎微信扫描二维码联系我们的票务经理